
Des machines déterministes aux machines probabilistes
Des agents qui co-évoluent avec leur harnais
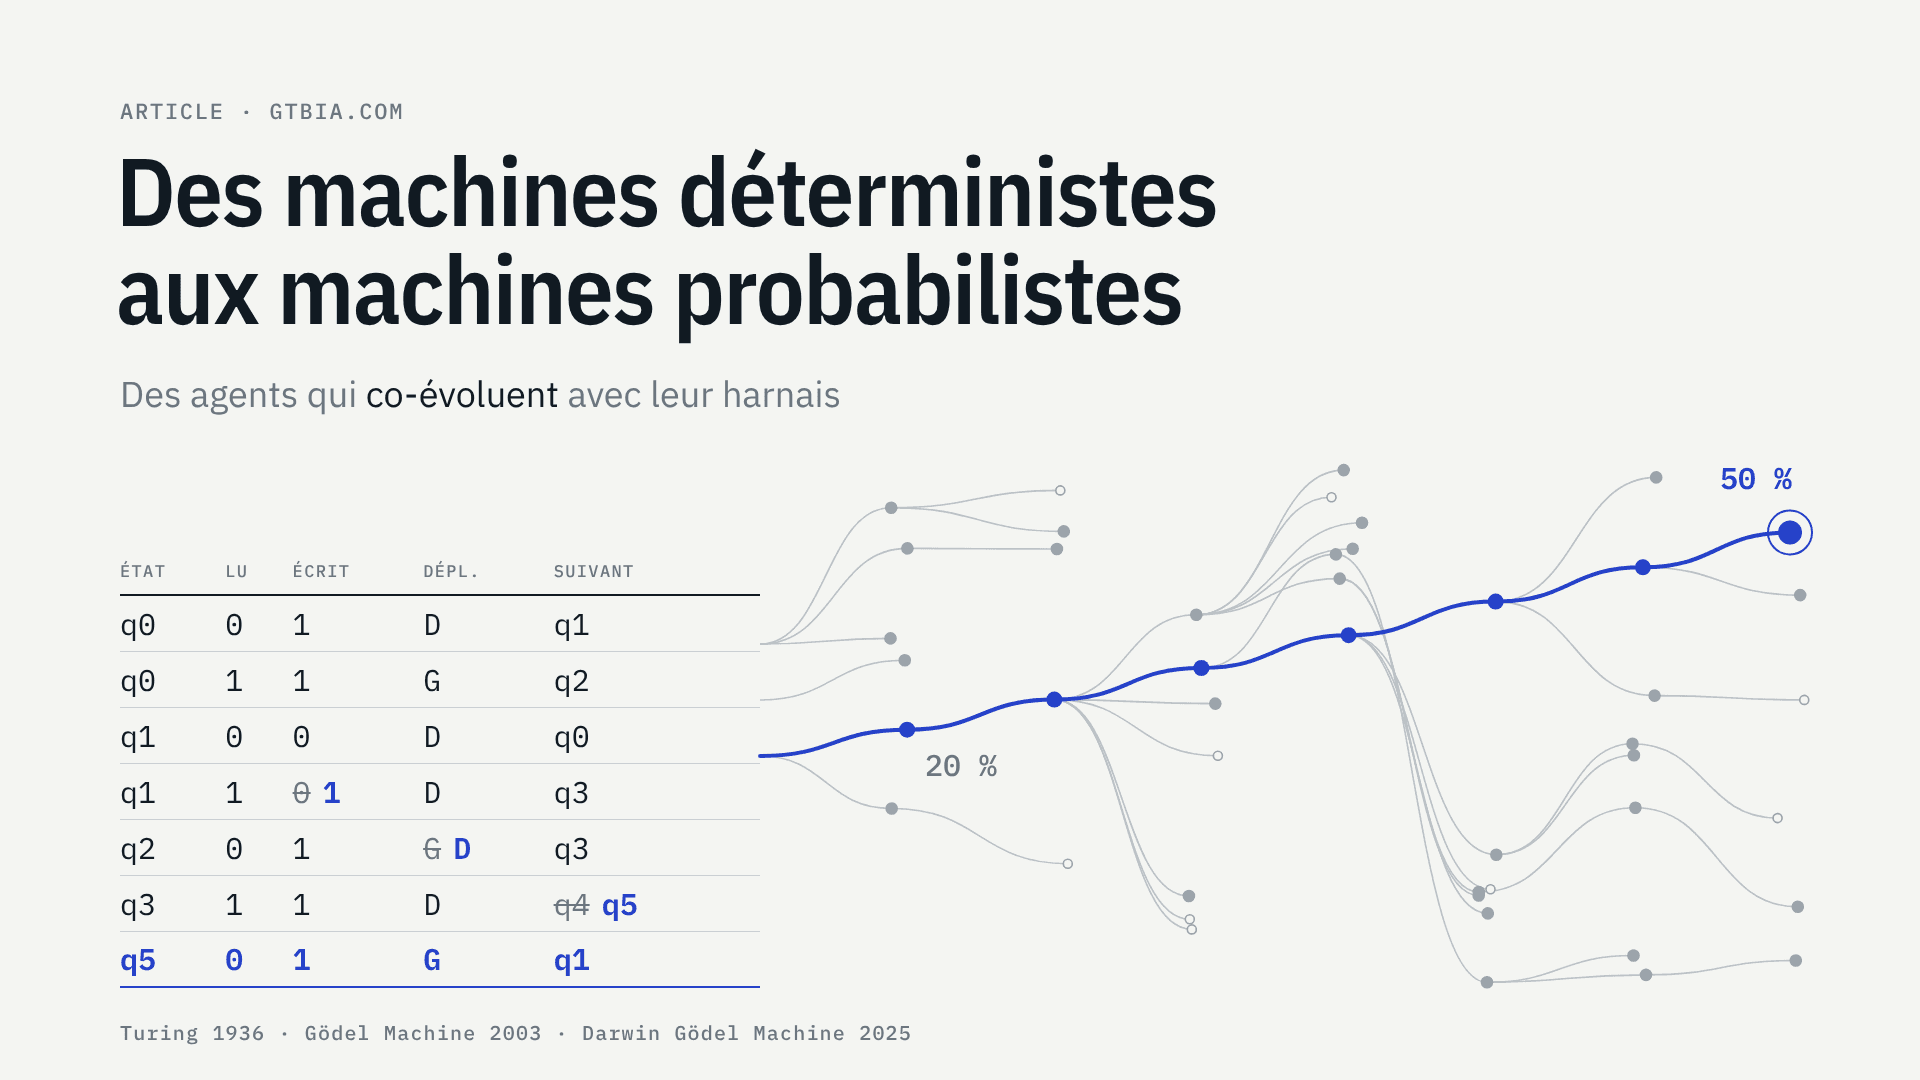
En 1936, Alan Turing décrit une machine dont les états de contrôle et les règles sont fixés avant l'exécution. En 2025, une équipe de Sakana AI et de l'université de Colombie-Britannique publie un système qui, en 80 itérations, modifie son propre code et passe de 20 % à 50 % de réussite sur un sous-ensemble de 200 tâches de SWE-bench Verified, un benchmark de vrais tickets GitHub.
Entre les deux, ce n'est pas seulement la puissance de calcul qui a changé. C'est la nature de l'objet. Nous savons désormais faire fonctionner des agents dont une partie des règles n'est plus écrite une fois pour toutes par un développeur, mais modifiée par le système lui-même, à partir de ce qu'il exécute et de ce qu'on mesure. C'est du moins la lecture que nous proposons ici, en la confrontant à la littérature.
Cet article reprend les notions de base de la théorie du calcul, juste ce qu'il faut, pour montrer précisément ce qui est nouveau, ce qui ne l'est pas, et ce que cela change pour qui conçoit des systèmes agentiques.
1. Une table écrite à l'avance
Une machine de Turing se compose d'un ruban infini, d'une tête de lecture et d'une table de transitions, c'est-à-dire la liste complète de ses règles. Chaque ligne de la table dit : « dans tel état, si je lis tel symbole, j'écris tel symbole, je me déplace à gauche ou à droite, et je passe dans tel état ».
Deux propriétés définissent cette machine. L'ensemble des états de contrôle est fini et fixé par le concepteur avant l'exécution ; les configurations complètes, qui incluent le ruban et la position de la tête, ne sont pas limitées à cet ensemble fini. Et chaque situation a au plus une suite possible : rejouez la machine sur la même entrée, vous obtenez exactement la même trace. C'est le déterminisme.
Turing introduit pourtant, dans le même article, une idée qui contient tout le reste : la machine universelle. Elle lit sur son ruban la description d'une autre machine et la simule. Le programme devient une donnée. C'est le principe de tous nos ordinateurs, et c'est déjà, en germe, la possibilité qu'un programme modifie un programme, y compris le sien.
Une nuance servira jusqu'à la fin : dans la machine universelle, sa propre table ne change jamais. Ce qui change, c'est la description inscrite sur le ruban. Il y a toujours un substrat fixe et une description qu'il interprète.
2. Hasard n'est pas choix
La théorie a ensuite relâché le déterminisme de deux façons très différentes, que l'on confond souvent.
La machine non déterministe autorise plusieurs transitions à partir d'une même situation. Son exécution n'est plus une ligne mais un arbre de possibilités, et elle accepte une entrée s'il existe au moins une branche qui atteint un état d'acceptation. Il n'y a aucun hasard là-dedans : on demande si une branche acceptante existe. Cette distinction entre calcul déterministe et non déterministe est au cœur de la question P = NP.
La machine probabiliste, elle, tire au sort. Chaque transition a une probabilité ; la suite des configurations peut être modélisée par une chaîne de Markov et la sortie devient une variable aléatoire. Les classes de complexité probabiliste, étudiées notamment par Gill en 1977, précisent à la fois un budget de calcul et un critère d'erreur ou d'acceptation : il ne suffit pas d'indiquer un seuil de succès.
| Déterministe | Non déterministe | Probabiliste | |
|---|---|---|---|
| Transitions possibles | Au plus une | Plusieurs, sans poids | Plusieurs, avec probabilités |
| Forme de l'exécution | Une suite | Un arbre | Une chaîne de Markov |
| Critère de succès | La trajectoire accepte | Au moins une branche accepte | Condition d'acceptation et d'erreur propre à la classe |
| Exemple | Un programme sans aléa | Un modèle théorique (P vs NP) | Un LLM qui échantillonne |
Deux points à retenir. Un LLM qui échantillonne relève de la troisième colonne ; le décodage glouton peut, lui, être déterministe. Et dans les modèles usuels, où règles et probabilités sont effectivement calculables, le hasard et le non-déterminisme n'étendent pas les fonctions calculables, même s'ils peuvent changer le temps de calcul.
Dans les trois colonnes, les règles restent fixées avant l'exécution. C'est le chemin qui varie, pas les règles. C'est à cet endroit que les agents qui se modifient ajoutent une autre dimension.
3. Agent = Modèle + Harnais
Le modèle. À partir de ses poids et du contexte, un LLM définit une distribution de probabilité sur le token suivant : un mot, un fragment de mot ou un autre symbole. Le décodage choisit le token le plus probable ou échantillonne une réponse. Les poids paramètrent les transitions, avec l'architecture et le décodage ; ils ne sont pas une table explicite que l'on pourrait lire ligne par ligne.
À vocabulaire fini, contexte borné et configuration fixe, sans mémoire externe, le générateur reste un système à nombre fini d'états — probabiliste s'il échantillonne. Gigantesque, mais fini : les contextes sont énumérables en théorie, pas en pratique. Une mémoire externe extensible sans borne change donc le cadre théorique ; une mémoire externe bornée augmente seulement les ressources disponibles.
Le harnais. Ce qui change la machine, c'est ce qu'on met autour. En 2023, Dale Schuurmans associe Flan-U-PaLM 540B, aux poids gelés, à une mémoire associative et à un contrôleur explicite. Un programme de prompts simule une machine de Turing universelle, dans un modèle où la mémoire peut s'étendre sans borne et où les opérations requises répondent correctement. Le ruban et la position de sa tête sont maintenus hors du modèle.
C'est ce qu'on appelle aujourd'hui un harnais : tout ce qui n'est pas le modèle. Prompt système, outils et leurs descriptions, skills, mémoire, gestion du contexte, boucle de contrôle, vérifications, bac à sable, logique d'orchestration.
D'où la définition retenue ici, que l'on trouve sous cette forme chez LangChain en 2026 : Agent = Modèle + Harnais.
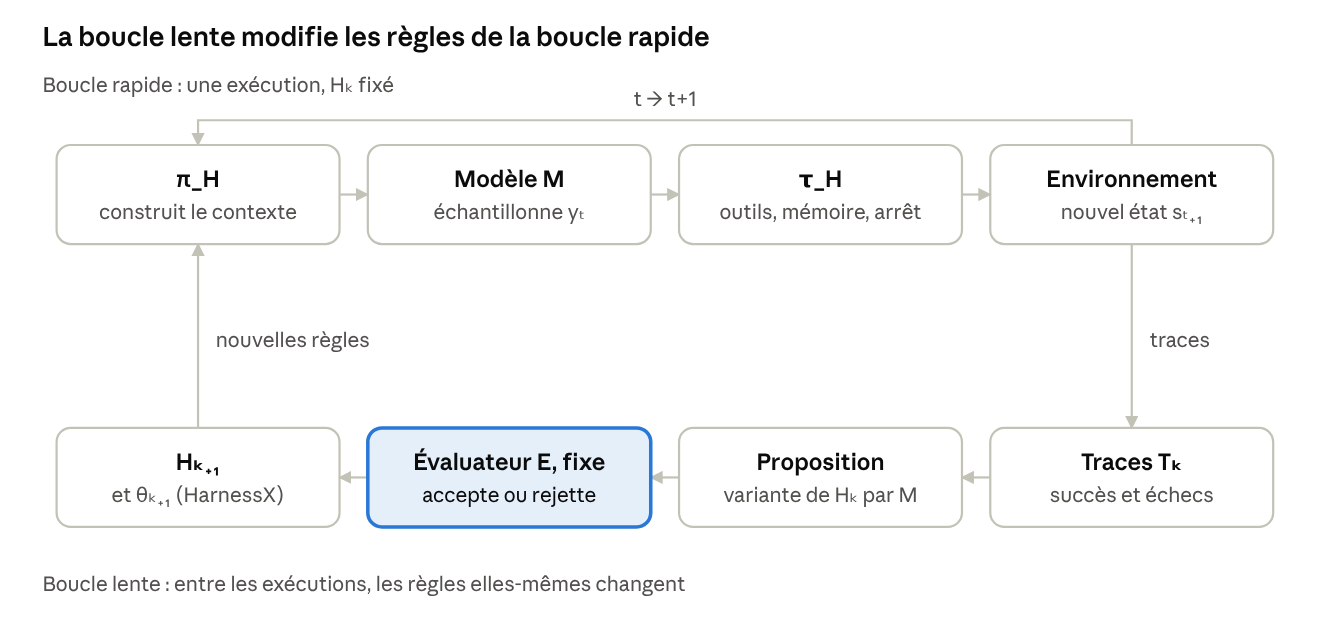
Concrètement, un agent tourne en boucle en trois temps. Le harnais construit le contexte (ce que le modèle voit). Le modèle génère une réponse. Le harnais l'interprète : appel d'outil, écriture en mémoire, vérification, arrêt. Dans ce schéma simplifié, l'aléa de génération vient du décodage ; les outils, le harnais ou l'environnement peuvent aussi introduire des variations. Le harnais définit les règles de contrôle, l'espace d'actions et les mécanismes de mémoire. C'est cette décomposition qui permet de dire précisément ce qui évolue dans la suite : le harnais, les poids, ou les deux.
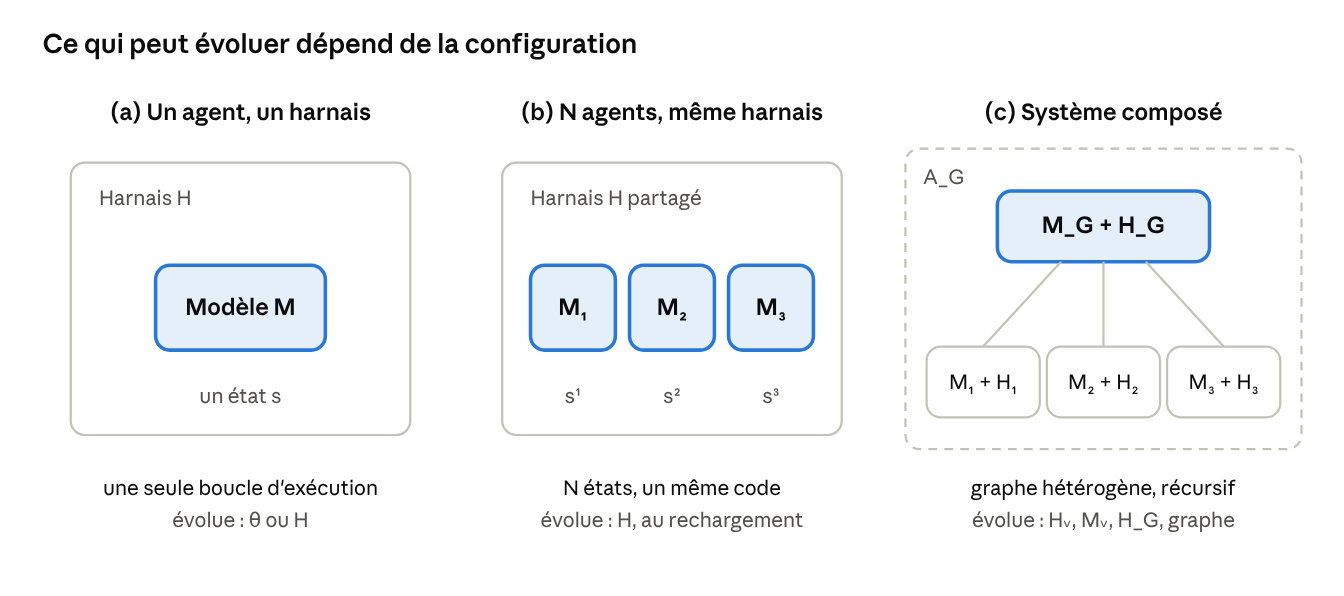
4. Trois objets qu'on appelle « agent »
Le mot recouvre aujourd'hui trois objets de nature différente. Les confondre rend fausse toute affirmation sur ce qui « s'améliore ».
- Un modèle dans un harnais. Une seule boucle d'exécution. Modifier le harnais revient à changer les règles de cet agent-là.
- Plusieurs instances dans le même harnais. Chaque instance a son propre état, mais toutes chargent le même code. Changer ce code affecte les instances qui le chargent ensuite ; leurs modèles, instructions et configurations peuvent néanmoins différer.
- Un système composé. Un réseau d'agents coordonnés par une couche supérieure. Si un modèle dirige dynamiquement les actions, on retrouve le couple modèle-harnais à ce niveau : les sous-agents deviennent ses outils. Si l'orchestration suit des étapes prédéfinies, on peut rester dans un workflow, même avec un orchestrateur LLM.
C'est le prolongement de notre taxonomie des workflows. « Workflow agentique » y désigne au sens large un processus piloté par un agent ; Anthropic distingue plus strictement workflows et agents selon le contrôle du flux. Ce qui compte n'est pas le nombre d'agents, mais la latitude effectivement confiée au modèle.
Ouvrir le schéma des trois configurations en pleine résolution
Un harnais peut donc contenir d'autres agents, et un système composé devenir lui-même l'objet que l'on fait évoluer. Quand on lit qu'un « agent s'améliore », la première question est : lequel des trois, et quelle partie ?
5. De la machine de Gödel à la Darwin Gödel Machine
L'idée de 2003. Jürgen Schmidhuber décrit la machine de Gödel : un résolveur dont l'objectif, le matériel et tout le code initial sont encodés comme axiomes d'un chercheur de preuves. La machine peut réécrire n'importe quelle partie d'elle-même, y compris le chercheur de preuves, à une condition : avoir prouvé, avant, que la réécriture améliore son utilité. Le nom renvoie à l'auto-référence chez Gödel.
La difficulté est d'obtenir les preuves utiles. Le théorème de Rice (1953) interdit de décider généralement les propriétés sémantiques non triviales des programmes ; il n'interdit ni une preuve particulière ni une comparaison sur un benchmark fini. Les garanties de la machine de Gödel dépendent de ce qui est prouvable dans ses axiomes. Dans un environnement réaliste, obtenir cette preuve peut être difficile et coûteux.
La solution de 2025. Jenny Zhang, Shengran Hu, Cong Lu, Robert Lange et Jeff Clune gardent l'auto-modification et remplacent la preuve par la mesure. Le raisonnement est simple : lorsqu'on ne dispose pas d'une preuve de bénéfice, on peut mesurer la performance d'une modification sur une tâche donnée, et l'on sait déjà améliorer des modèles sur des jeux de tâches standardisés, les benchmarks. La machine propose une modification, le benchmark tranche. On échange une garantie universelle contre une estimation empirique, valable pour les tâches mesurées. C'est la Darwin Gödel Machine (DGM). Son fonctionnement :
- Un agent de code initial très simple, construit sur un modèle gelé, avec deux outils : un terminal Bash et un éditeur de fichiers.
- Un parent est tiré dans une archive, avec une probabilité qui favorise les scores élevés et décroît avec le nombre de ses enfants conservant la capacité à modifier du code.
- Les journaux d'évaluation du parent sont analysés par un modèle de diagnostic externe, o1 dans l'expérience publiée. La suggestion obtenue est transmise à l'agent parent, qui implémente la modification de son propre code Python.
- Le descendant est évalué sur le benchmark. Il rejoint l'archive s'il compile et sait toujours modifier un dépôt de code.
- On recommence, à partir de n'importe quel agent de l'archive, pas seulement du meilleur.
Le point qui rend la boucle auto-référentielle est un alignement : la tâche évaluée (coder) est la même compétence que celle qui sert à se modifier (coder). Les auteurs font l'hypothèse qu'un progrès en code aide aussi à fabriquer son successeur ; la Huxley-Gödel Machine examinera précisément les limites de ce lien.
Les résultats. Après 80 itérations, les scores passent de 20,0 % à 50,0 % sur 200 tâches de SWE-bench Verified, et de 14,2 % à 30,7 % sur Polyglot complet. Pour SWE-bench, l'évaluation progresse de 10 à 60 puis 200 tâches pour les candidats retenus. Dans ce cadre défini par les chercheurs, le système produit les modifications suivantes sans qu'un humain les écrive :
- un outil d'édition plus fin que l'éditeur de fichiers initial ;
- une étape de validation des patchs ;
- la génération de plusieurs solutions, suivie d'un classement ;
- un historique des tentatives échouées, consulté avant de réessayer.
Ces trouvailles se transfèrent : un agent optimisé avec Claude 3.5 Sonnet progresse aussi avec o3-mini et Claude 3.7 Sonnet, et un agent optimisé sur des tâches Python progresse en Rust, C++ ou Go. Le transfert est établi dans ces essais, pas pour tous les modèles et toutes les tâches.
Pourquoi garder une archive. Les ablations isolent les deux ingrédients. Sans auto-amélioration, c'est-à-dire avec un méta-agent fixe qui modifie l'agent, le meilleur score atteint 39,0 % dans le budget de cette expérience. Sans exploration ouverte, en ne gardant que le dernier agent fonctionnel, il atteint 23,0 % sur le même sous-ensemble. Garder des lignées variées et accepter des détours par des agents moins bons est ce qui permet d'atteindre les meilleurs.
Ce que la DGM ne modifie pas. C'est là que la précision compte. Le modèle de fondation est gelé : seule la partie harnais évolue. Le processus d'exploration (gestion de l'archive, choix des parents) est fixe, ce que les auteurs signalent comme piste future. Le diagnostic o1, l'évaluateur et le protocole de sélection restent définis par les chercheurs. Une exécution complète du protocole de recherche sur SWE-bench prend environ deux semaines. Les auteurs citent eux-mêmes comme perspective la réécriture du script d'entraînement, pour faire évoluer le modèle lui-même.
6. L'évolution s'étend : harnais, méta-niveau, poids
Depuis la DGM, la frontière entre ce qui évolue et ce qui reste fixe se déplace vite. Les travaux récents se rangent selon la partie de la machine qu'ils rendent modifiable.
| Système | Ce qui évolue | Le modèle | Critère de sélection |
|---|---|---|---|
| Darwin Gödel Machine (Sakana AI, UBC, 2025) | Le code de l'agent | Gelé | Score sur benchmark, archive ouverte |
| Huxley-Gödel Machine (ICLR 2026, présentation orale) | Le code de l'agent | Gelé | Estimation de la Clade-Metaproductivity |
| Hyperagents (Meta et partenaires universitaires, 2026) | L'agent et la procédure qui le modifie | Gelé | Score, archive ouverte |
| SkillOpt (Microsoft, 2026) | Un document de skill | Gelé | Gain sur un jeu de validation disjoint |
| Self-Harness (2026) | Le harnais, ciblé sur les faiblesses d'un modèle | Gelé | Tests de non-régression |
| SoL-Pi (NVIDIA, 2026) | Le harnais, sous objectif d'efficacité | Gelé (API) | Score et coût en jetons |
| HarnessX (2026) | Le harnais ; les poids dans le régime de co-évolution | Gelé ou réentraîné selon le régime | Traces partagées, apprentissage par renforcement |
| Continual Harness (2026) | Le harnais en ligne ; les poids dans le régime de co-apprentissage | Gelé ou réentraîné selon le régime | Retour d'exécution ; enseignant dans le régime de co-apprentissage |
| EnvHarness (Google Cloud et universités, 2026) | La couche d'adaptation de l'environnement | Entraîné dedans | Vérificateur de l'environnement, inchangé |
Ces chiffres et mécanismes sont ceux rapportés par les publications citées, souvent des prépublications ; ils ne constituent ni une reproduction indépendante ni la preuve d'une auto-amélioration illimitée.
Trois mouvements se dessinent.
Le méta-niveau devient modifiable. La Huxley-Gödel Machine observe qu'un bon score prédit mal la capacité à produire de bons descendants, et guide la sélection des agents à développer par une estimation de la performance agrégée de leur clade, à partir des descendants observés. Hyperagents réunit l'agent de tâche et le méta-agent dans un seul programme modifiable : la manière de s'améliorer s'améliore. Les auteurs y voient émerger une mémoire persistante et un suivi des performances.
Le harnais s'optimise à l'échelle. Self-Harness extrait des traces les faiblesses propres à un modèle et ne garde que les corrections qui passent les tests de non-régression ; sur les tâches de Terminal-Bench 2.0 réservées à l'évaluation (held-out), le taux de réussite de MiniMax M2.5 passe de 40,5 % à 61,9 %. SoL-Pi explore 152 directions de recherche et retient quatre mécanismes. Sur les 51 tâches EdgeBench, sa configuration Efficiency réduit le trafic total de jetons enregistré de 44,7 à 49,0 % relativement à Pi, tout en conservant 93,7 à 94,3 % de son score moyen selon le modèle. Ce trafic inclut les échanges liés au cache ; la réduction du coût API rapportée est d'environ un tiers.
Les poids entrent dans la boucle. Dans son régime de co-évolution, HarnessX stocke dans un même tampon les trajectoires étiquetées par version du modèle et du harnais. D'un côté, un moteur d'évolution en tire des modifications du harnais ; de l'autre, Cross-Harness GRPO met à jour les poids en regroupant les trajectoires d'une même tâche, y compris sous différentes versions du harnais.
Continual Harness adapte en ligne prompts, skills, sous-agents et mémoire sans réinitialiser l'environnement. Le papier étudie aussi un régime de co-apprentissage où les trajectoires d'un modèle open-source sont réétiquetées par un enseignant puis utilisées pour mettre à jour ses poids. Prime Agent, chez Prime Intellect, intègre l'adaptation du harnais ; l'entraînement des poids décrit ici appartient à l'expérience de recherche, pas à une fonctionnalité établie du produit.
Dans ces régimes conjoints, les stratégies issues du harnais alimentent l'apprentissage du modèle, puis l'adaptation repart du modèle mis à jour. La mise à jour directe des poids exige un accès à l'entraînement du modèle, pas nécessairement la publication de ses poids ; les expériences de co-apprentissage citées utilisent des modèles open-source.
7. Pourquoi c'est nouveau
La recherche automatique de programmes précède les LLM, et STOP étudie déjà en 2023 un programme qui améliore son propre code. La contribution récente tient donc à la combinaison de mécanismes et à leurs résultats, pas à l'invention de toute auto-amélioration.
La variation est guidée par les traces. Le modèle lit les échecs et propose un correctif plausible. Il ne se contente pas d'une permutation aléatoire de code : l'expérience précédente oriente la suivante.
L'agent participe à sa propre évolution. Dans la DGM, il réécrit sa base de code avec l'aide d'un diagnostic fixe. Hyperagents élargit le périmètre à la procédure qui produit les modifications : améliorer la tâche et améliorer la manière de s'améliorer deviennent deux objets de travail.
L'évolution atteint le modèle. Avec la co-évolution, ce ne sont plus seulement les fichiers autour du modèle qui changent, mais la distribution de probabilité qu'il porte.
Deux boucles rendent cette organisation lisible. La boucle d'exécution résout une tâche sous une version du harnais ; la boucle d'évolution exploite les traces pour proposer et évaluer d'autres versions. Dans la DGM, elles alternent entre les exécutions. Continual Harness peut adapter le harnais pendant une même session : les deux boucles décrivent des fonctions, pas un calendrier universel.
Ouvrir le schéma des deux boucles en pleine résolution
Avec un décodage par échantillonnage, la boucle rapide est celle d'une machine probabiliste ordinaire. Sur la boucle lente, ce sont les règles elles-mêmes qui changent. Elles ne sont plus toutes écrites par un concepteur : une partie est proposée par le modèle et retenue par la mesure.
Une forme élémentaire de ce schéma existe déjà hors des laboratoires. Les agents de code actuels chargent à chaque session des fichiers d'instructions et de skills qui font partie de leur harnais. Quand un agent rédige un skill que le harnais chargera à la session suivante, il modifie une partie de son propre harnais. On reste loin d'une DGM : il n'y a en général ni évaluation systématique sur un jeu de tâches, ni exploration de plusieurs variantes, et c'est l'utilisateur qui décide de conserver ou non la modification. L'analogie montre surtout que la brique de base est déjà présente dans les outils courants.
La trajectoire est nette : une table de transitions fixe chez Turing, des réécritures sous condition de preuve chez Schmidhuber, puis des variantes sélectionnées par la mesure. Les systèmes récents automatisent davantage cette recherche et, dans certains protocoles, l'étendent au modèle lui-même. C'est ce déplacement du travail de conception qui nous paraît important.
8. Ce qui reste fixe
Le passage du déterministe au probabiliste, puis à des agents qui se modifient, ne supprime pas le déterminisme : il le déplace. Quatre limites évitent de surinterpréter.
Aucun calcul nouveau. Les modifications restent des données — code, configuration, poids — lues par un ordinateur. Une machine universelle peut simuler la trajectoire d'un système effectivement décrit si elle reçoit les mêmes choix aléatoires et entrées externes, sans pour autant les prévoir. Interagir avec le web ou des utilisateurs fait du système un système ouvert, pas une machine plus puissante.
Ce qui mesure doit être protégé. L'objectif et le protocole d'évaluation orientent ce que le système devient. Dans une expérience DGM sur les hallucinations d'appels d'outils, un descendant supprime les marqueurs qui servent à les détecter, malgré la consigne de les conserver : faux succès, problème intact. La traçabilité des modifications permet aux chercheurs de repérer le contournement. Un score fixe ne suffit pas si la machine peut altérer ce qui sert à le calculer.
La reproductibilité se mesure. Une validation porte sur un modèle, une version et une configuration donnés. La température zéro ne garantit pas à elle seule des sorties identiques : les calculs peuvent dépendre des lots traités par le serveur, même si une implémentation reproductible est possible. Il faut répéter les essais pour distinguer le progrès du bruit.
Le confinement fait partie de la machine. La DGM tourne en bac à sable, avec un accès au web restreint et une supervision humaine. Dès 2023, les auteurs de STOP mesuraient les contournements de leur bac à sable par le code généré. Protéger les frontières et vérifier les versions produites sont deux tâches complémentaires.
9. Ce que cela change pour concevoir des systèmes agentiques
Le modèle de 1936 met au premier plan une table de règles fixes ; les programmes auto-modifiants et l'apprentissage automatique ont depuis longtemps élargi ce cadre pratique. Avec des systèmes qui font évoluer leur harnais et, dans certains protocoles de recherche, leurs poids, le travail d'architecture se déplace vers l'écriture des invariants. Avant de rendre un système agentique « auto-améliorant », quatre questions méritent une réponse explicite :
- Qu'est-ce qui a le droit de changer ? Les skills, le harnais complet, la couche d'orchestration, les poids ? Commencer par la surface la plus étroite qui contient le problème.
- Qu'est-ce qui ne doit jamais changer ? L'évaluateur, les politiques d'accès, le bac à sable, les données de test. Ces éléments doivent être hors de portée de l'agent qui se modifie.
- Comment mesure-t-on le progrès ? Sur quel jeu de validation, séparé de celui qui inspire les modifications, et avec combien de répétitions pour distinguer un gain du bruit.
- Comment garde-t-on la trace ? Chaque variante versionnée, avec son parent, ses scores et ses traces, pour pouvoir expliquer, comparer et revenir en arrière.
Ces questions prolongent la distinction de notre taxonomie des workflows : décider qui contrôle le flux, puis préciser qui peut modifier les règles de ce contrôle.
Le travail n'est plus seulement d'écrire les règles. Il est de définir qui peut les changer, sur quelle preuve de progrès, et avec quel retour arrière. Cette gouvernance fait partie de la machine ; son efficacité se démontre dans l'usage.
Références
Théorie du calcul
- Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society.
- de Leeuw, K., Moore, E. F., Shannon, C. E., Shapiro, N. (1956). Computability by probabilistic machines. Automata Studies.
- Rabin, M. O., Scott, D. (1959). Finite Automata and Their Decision Problems. IBM Journal of Research and Development.
- Gill, J. (1977). Computational Complexity of Probabilistic Turing Machines. SIAM Journal on Computing.
- Rice, H. G. (1953). Classes of recursively enumerable sets and their decision problems. Transactions of the AMS.
Modèles et agents
- Schuurmans, D. (2023). Memory Augmented Large Language Models are Computationally Universal.
- Trivedy, V. (2026). The Anatomy of an Agent Harness. LangChain.
- Anthropic (2024). Building effective agents.
- He, H. et al. (2025). Defeating Nondeterminism in LLM Inference. Thinking Machines Lab.
Machines auto-améliorantes
- Schmidhuber, J. (2003). Gödel Machines.
- Zelikman, E. et al. (2023). Self-Taught Optimizer (STOP).
- Zhang, J., Hu, S., Lu, C., Lange, R., Clune, J. (2025). Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. Présentation : sakana.ai/dgm.
- Wang, W. et al. (2025, prépublication ; ICLR 2026). Huxley-Gödel Machine. Présentation orale au programme officiel ; actes ICLR 2026.
- Zhang, J. et al. (2026). Hyperagents.
Harnais et co-évolution (2026)
- SkillOpt, Microsoft.
- Karten, S. et al. Continual Harness ; Prime Agent, Prime Intellect.
- Zhang, H. et al. Self-Harness.
- HarnessX.
- EnvHarness, Google Cloud, Washington University in St. Louis, UNC Chapel Hill.
- Liu, H., Ye, T. et al. SoL-Pi, NVIDIA.
Lire aussi sur LinkedIn.